Verschmutzte Prägungen. Beschädigte Zeichen. Uneinheitliche ID-Kennzeichnungen.
PSI Technics GmbH – Lesedauer ca. 5 Minuten – OCR – Deep Learning – Zeichenerkennung – mupudia VISION
Wenn herkömmliche OCR-Systeme passen – und warum Deep Learning den Unterschied macht
Verschmutzte Prägungen. Exotische Schrifttypen. Beschädigte Zeichen. Uneinheitliche ID-Kennzeichnungen. Herkömmliche OCR-Systeme scheitern hier regelmäßig. Der modulare OCR-Klassifikator von PSI Technics wurde genau für diese Fälle entwickelt – und wird mit jedem Projekt besser.
Das Problem mit klassischer Texterkennung
Optical Character Recognition (OCR) gibt es seit Jahrzehnten. Für gedruckten, sauberen Text auf weißem Hintergrund funktioniert es gut. In der industriellen Praxis sieht es anders aus.
Gehänge-IDs in der Fahrzeugproduktion, eingravierte Seriennummern auf Metallteilen, Kennzeichnungen auf Verpackungen nach stundenlangem Transportweg, Zeichensätze, die jede Anlage etwas anders druckt – das ist die Realität, mit der OCR-Systeme in der Industrie konfrontiert werden.
Klassische OCR-Ansätze, die auf festen Regeln und Schrifterkennung nach Vorlage basieren, können mit dieser Variabilität nicht umgehen. Schon eine leichte Verschmutzung, eine ungewohnte Schriftart oder ein beschädigtes Zeichen kann die Erkennung zum Scheitern bringen.
Der Unterschied zwischen einem OCR-System, das 80 % der Fälle erkennt, und einem, das 99 % erkennt, ist in der Produktion enorm – bei 10.000 Teilen am Tag bedeutet das 2.000 manuelle Nachkorrekturen.
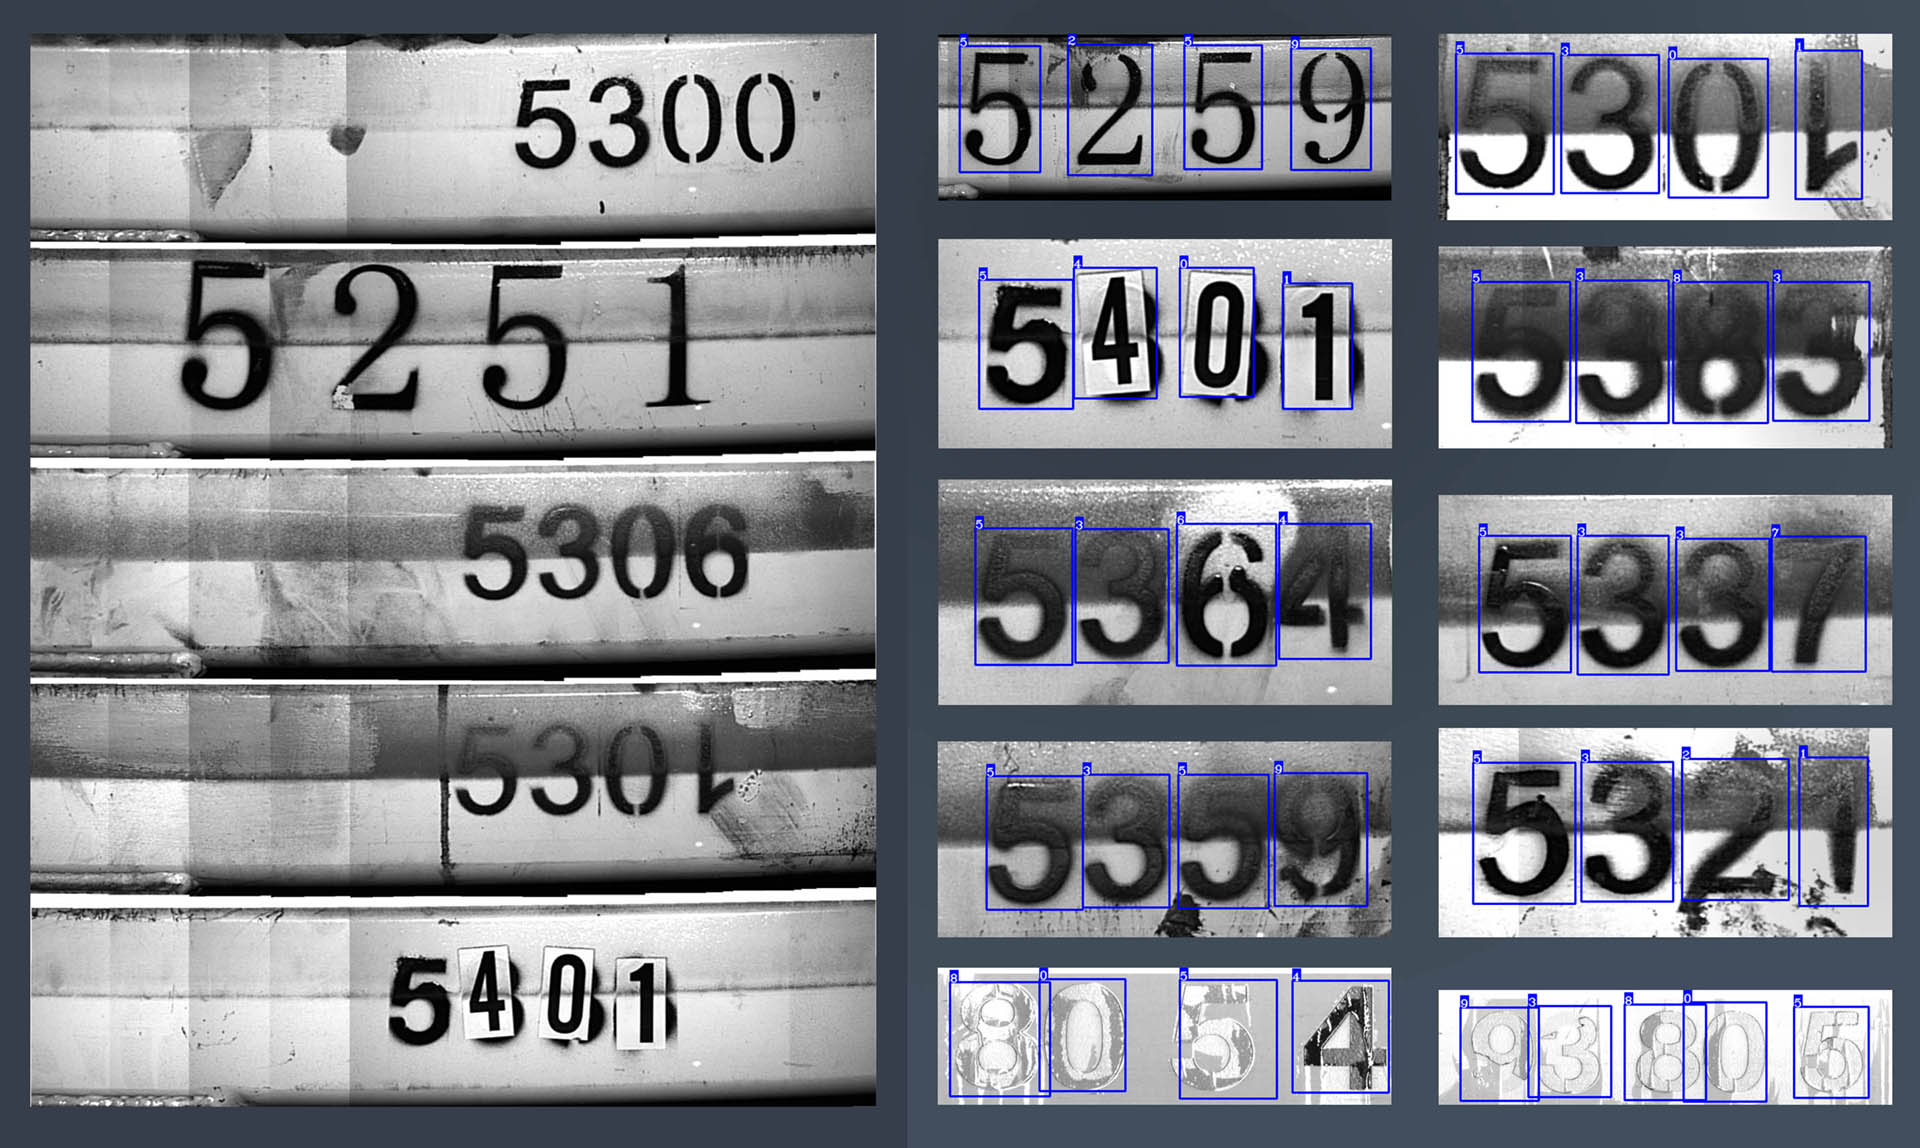
Der OCR-Klassifikator erkennt auch komplexe oder sehr schwer lesbare Schriftbilder oder Texte – selbst bei Verschmutzung und Beschädigung der Zahlen, Ziffern und Buchstaben. – Beispiele aus der Fahrzeugherstellung – Uneinheitliche ID's an Gehängen, spezielle Zeichensätze, verschmutztes und teilweise auch fehlerhaftes, beschädigtes Schriftbild – kein Problem für den OCR-Klassifikator.
Wie der modulare OCR-Klassifikator funktioniert
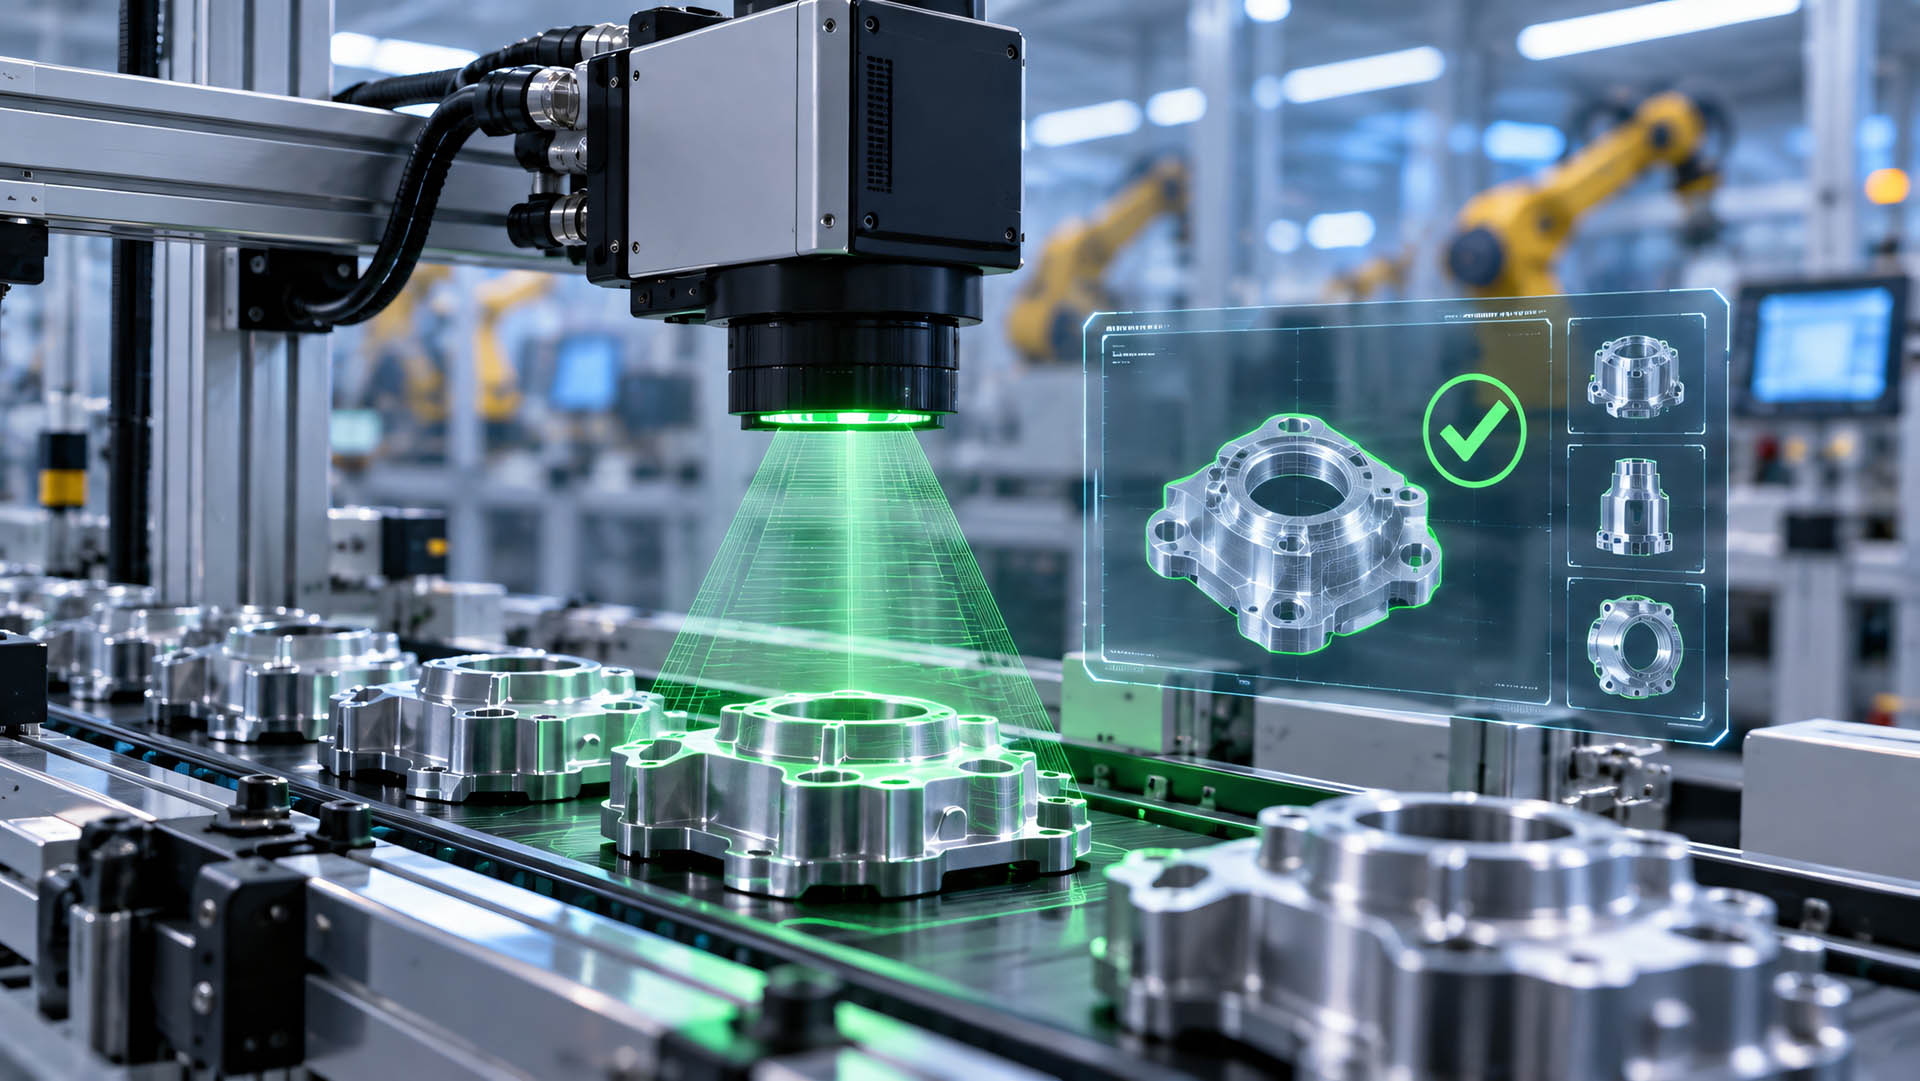
Der OCR-Klassifikator von PSI Technics basiert nicht auf statischen Regeln, sondern auf spezialisierten neuronalen Netzen, die kontinuierlich trainiert werden. Das Prinzip: Je mehr Daten das System sieht, desto zuverlässiger wird seine Erkennung – auch für Zeichen, die vorher nie im System waren.
Die Basis bilden Datensätze aus bereits realisierten Projekten. Damit startet der Klassifikator nicht bei null, sondern bringt bereits eine breite Abdeckung bekannter Zeichensätze mit. Neue, bisher unbekannte Zeichen können vom Kunden direkt in die Cloud geladen werden – das System wird automatisch weiter trainiert.
Bilddaten erfassen
Kamera nimmt Zeichen auf – direkt live oder aus gespeicherten Datensätzen.
Klassifikator wertet aus
Das neuronale Netz erkennt Zeichen, Zahlen und Texte – auch bei schwierigem Schriftbild.
Neue Daten eintrainieren
Unbekannte Zeichensätze werden in die Cloud geladen und das Modell weiter trainiert.
Klassifikator wird besser
Mit jedem neuen Datensatz steigt die Erkennungsrate – kontinuierlich, automatisch.
Das Ergebnis ist ein System, das mit jedem Einsatz besser wird – nicht trotz, sondern wegen der Vielfalt an Daten, die es im Laufe der Zeit verarbeitet.
Was der Klassifikator erkennt – und was ihn auszeichnet
Wo herkömmliche ODR scheitert
Stark verschmutzte Zeichen, exotische oder selbst definierte Schrifttypen, beschädigte Prägungen, unterschiedliche Druckqualitäten innerhalb derselben Anlage, sehr kleine oder sehr große Schrift – all das überfordert regelbasierte OCR-Systeme systematisch.

Aktivierung bei Bedarf
Kein separates System, kein separater Aufwand
Zugriff auf Bilddaten genügt
Keine zusätzliche Hardware erforderlich
Bilder von Server
Oder lokal einlesbar, komprimiert oder unkomprimiert
Neue Datensätze vom Kunden
Direkt in die Cloud ladbar
Aktuellster Klassifikator
Jederzeit über unsere Plattform verfügbar
Schnelle Integration
In bestehende Projekte ohne Mehraufwand
Ein OCR-System, das 80 % sicher ist, braucht eine Fehlerbehandlung für die restlichen 20 %. Eines, das 99 %+ erreicht, verändert die Prozesskette grundlegend.
Wann lohnt sich der Einsatz?
Der modulare OCR-Klassifikator lohnt sich immer dann, wenn Zeichenerkennung Teil eines Produktions- oder Prüfprozesses ist – und wenn die Anforderungen an Zuverlässigkeit hoch sind. Das ist insbesondere der Fall, wenn:
- die zu erkennenden Zeichen variabel, verschmutzt oder beschädigt sind,
- die Erkennungsrate bei herkömmlichen Systemen nicht ausreicht,
- der Prozess keine manuelle Nachkontrolle erlaubt,
- oder unterschiedliche Zeichensätze in derselben Anlage vorkommen.
Als optionales Modul ist der Klassifikator leicht in bestehende mupudia VISION Systeme integrierbar – ohne zusätzliche Hardware, ohne langen Implementierungsaufwand.
Haben Sie eine OCR-Aufgabe, bei der herkömmliche Verfahren scheitern?
Sprechen Sie mit unseren Anwendungsberatern. Wir prüfen gemeinsam, ob der modulare OCR-Klassifikator Ihre Anforderungen erfüllt – und wie er sich in Ihre bestehende Infrastruktur integrieren lässt.
E-Mail: support@psi-technics.com
Telefon: +49 (0) 2630 91590-0
Häufig gestellte Fragen (FAQ)
Klassische OCR-Ansätze basieren auf festen Regeln und Schrifterkennung nach Vorlage. Schon eine leichte Verschmutzung, eine ungewohnte Schriftart oder ein beschädigtes Zeichen kann die Erkennung zum Scheitern bringen – etwa bei eingravierten Seriennummern, Gehänge-IDs oder Kennzeichnungen nach langem Transportweg.
Der OCR-Klassifikator basiert nicht auf statischen Regeln, sondern auf spezialisierten neuronalen Netzen, die kontinuierlich trainiert werden. Je mehr Daten das System sieht, desto zuverlässiger wird die Erkennung – auch für Zeichen, die vorher nie im System waren.
Der Unterschied zwischen 80 % und 99 % Erkennung ist in der Produktion enorm: Bei 10.000 Teilen am Tag bedeutet eine Erkennungsrate von 80 % rund 2.000 manuelle Nachkorrekturen täglich. Eine höhere Erkennungsrate reduziert diesen Aufwand drastisch.
Nein. Der Klassifikator bringt aus bereits realisierten Projekten eine breite Abdeckung bekannter Zeichensätze mit und startet nicht bei null. Neue, bisher unbekannte Zeichen können direkt in die Cloud geladen werden – das System wird automatisch weiter trainiert und mit jedem Projekt besser.